登录社区云,与社区用户共同成长
邀请您加入社区
LLM(大语言模型)微调一直都是老大难问题,不仅因为微调需要大量的计算资源,而且微调的方法也很多,要去尝试每种方法的效果,需要安装大量的第三方库和依赖,甚至要接入一些框架,可能在还没开始微调就已经因为环境配置而放弃了。今天我们分享一个开源项目可以快速进行 LLM 微调,它不单运行效率高,而且还可以在微调过程中进行可视化,非常方便,它就是:LLaMA Factory。
本文详细介绍了11种大型语言模型的参数高效微调方法,包括前缀调优、提示调优、LORA及其变体、QLORA、LongLORA等。这些方法通过冻结预训练模型参数,仅优化少量特定参数或采用量化技术,显著减少微调时的计算资源消耗,同时保持模型性能,为大型语言模型的高效应用提供多种解决方案。
精确的医学图像分割需要整合从局部特征到全局依赖的多尺度信息。然而,现有方法在建模长距离全局信息方面存在挑战,其中卷积神经网络受到其局部感受野的限制,视觉变换器因其注意力机制的高二次复杂性而受到限制。最近,基于Mamba的模型因其在长序列建模方面的卓越能力而受到广泛关注。一些研究表明,这些模型可以在各种任务中胜过流行的视觉模型,提供更高的准确性、更低的内存消耗和更小的计算负担。然而,现有的基于Mam
当你向ChatGPT提问时,它总能给出令人满意的回答,仿佛拥有无穷无尽的知识。这种近乎魔法的能力是如何获得的?答案就隐藏在一个被称为"预训练"的神秘过程中。想象一下,如果要教会一个孩子理解和运用语言,我们会让他大量阅读各种文本,从童话故事到百科全书,从新闻报道到诗歌散文。大模型的预训练过程与此类似,只不过规模要庞大得多。整个过程始于对互联网上海量文本数据的收集,这些数据涵盖了人类知识的方方面面——
摘要 本项目旨在通过微调Deepseek-R1大模型提升银行系统的智能化水平,应对金融科技快速发展背景下的银行业务挑战。项目聚焦于客户服务自动化、风险管理、业务流程优化三大核心场景,通过数据收集与预处理、模型微调与优化、系统集成与测试、持续监控与迭代四个阶段实施。微调后的模型将显著提升银行在自然语言处理、风险预测、欺诈检测等方面的能力,预计客户服务推荐准确率提升14%,风险控制预警准确率提升11%
通用机器人模型,目前最大的障碍便是「异构性」。也就是说,必须收集全方位——每个机器人、任务和环境的特定数据,而且学习后的策略还不能泛化到这些特定设置之外。由此,AI大神何恺明带队的MIT、Meta FAIR团队,提出了异构预训练Transformer(HPT)模型。即预训练一个大型、可共享的神经网络主干,就能学习与任务和机器人形态无关的共享表示。简单讲,就是在你的策略模型中间放置一个可扩展的Tra
好久没有写文章了,Qwen3最近也挺火的,知乎一直在谈论小参数模型的作用是啥。所以我突发奇想,想用Qwen3-1.7b的小模型配合猫娘问答数据集草草训练一只猫娘,自我感觉效果不错。先来看一下微调效果。我说“我不爱你了!哼!{"role" : "user", "content" : "我不爱你了!哼!"}模型的回复:说实话,能回答成这样,我也是有一点震惊的!我的猫娘!!!嘿嘿嘿哈!!!另外,整个项目
OccFeat是一种用于纯相机BEV分割网络的自监督预训练方法,它能同时加强对3D场景的几何和语义理解。
过去,大语言模型(**Large Language Models, LLMs**)的对齐依赖一个关键组件:**奖励模型(Reward Model)**。奖励模型通常基于昂贵的人类偏好数据(human preference data)训练,用于指导强化学习(**Reinforcement Learning, RL**)以优化最终策略。
23年1月来自CMU和国立新加坡大学ACM Computing Surveys发表的综述论文“Pre-train, Prompt, and Predict: A Systematic Survey of Prompting Methods in Natural Language Processing“。
实际应用中,LoRA 因效率优势成为主流,而全量微调更多用于追求极致性能的场景。
随着 ChatGPT 的爆火,很多机构都开源了自己的大模型,比如清华的 ChatGLM-6B/ChatGLM-10B/ChatGLM-130B,HuggingFace 的 BLOOM-176B。当然还有很多没有开源的,比如 OpenAI 的 ChatGPT/GPT-4,百度的文心一言,谷歌的 PLAM-540B,华为的盘古大模型,阿里的通义千问,等等。
该数据集可用于电动车进电梯检测算法,电动车进电梯检测采用基于AI算法的机器视觉图像感知技术,对电动车实现精确检测、识别,准确检测到电瓶车进电梯,并快速进行预警反应,可实时预警电梯区域内电动车闯入事件。
预训练语言模型虽然在自然语言任务中取得了很好的效果,但是由于这类模型于模型参数量与训练数据量十分庞大,导致在单张卡上无法储存完整的模型,传统的单机单卡的训练方式已无法满足模型的训练,以及在部署推理模型时,庞大的参数量限制了推理速度与相应服务的扩展性。采用多机多卡的训练方式是缓解大规模预训练模型难以训练的有效手段。为此,多机多卡间通信、模型并行与数据并行时梯度的同步等问题受到了许多关注,各种训练框架
VGG16报错:https://download.pytorch.org/models/vgg16-397923af.pth。inception_v3报错:https://download.pytorch.org/models/inception_v3_google-1a9a5a14.pth。模型保存路径:/home/主机名/.cache/torch/checkpoints/vgg16-39792
包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!😝有需要的小伙伴,可以保存图片到。
相比之下,到目前为止,我们与LLMs的大多数交互都是基于会话的,LLMs在不同会话之间基本上是无状态的。相反,增加代码混合比例可能会损害模型在其他任务上的表现,包括需要对语言结构(如句法或形态)敏感的任务,以及衡量现实世界知识的任务。在关于AI研究科学家的论文发表之后,一个重要的问题浮现出来:基于大语言模型(LLM)的智能代理是否真的能够产生新颖的研究想法。很多人学习大模型的时候没有方向,东学一点
本文介绍大模型微调技术,如何通过LLaMA-Factory Online将通用Qwen3-Omni模型微调为专业文博解说AI,解决领域幻觉问题,实现从“通才”到“专才”的转变。
点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba/多模态/扩散】交流群添加微信号:CVer111,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!转载自:晓飞的算法工程笔记首个针对使用合成数据训练的模型在不同稳健性指标上进行详细分析的
文章摘要: 本文解释了YOLO模型配置中的常见误区。当使用YOLO("yolo11n-seg.yaml").load("yolo11m.pt")时,实际调用的是n-scale模型结构,仅加载m模型的预训练参数,最终模型大小仍接近n。要获得m-scale模型,需修改为YOLO("yolo11m-seg.yaml")。关键点包括:1) YOL
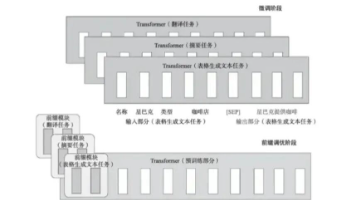
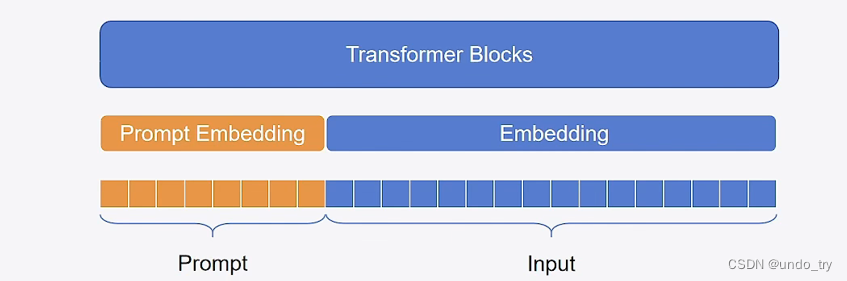
前缀调优(PrefixTuning)是一种轻量级的微调替代方法,专门用于自然语言生成任务。前缀调优的灵感来自于语言模型提示,前缀就好像是“虚拟标记”一样,这种方法可在特定任务的上下文中引导模型生成文本。前缀调优的独特之处在于它不改变语言模型的参数,而是通过冻结LM参数,仅优化一系列连续的任务特定向量(即前缀)来实现优化任务,如图1所示。
在学术论文撰写、专业报告创作过程中,人工智能生成内容(AIGC)虽提升了创作效率,但过高的 AIGC 总体疑似度可能引发原创性质疑,影响成果审核与发表。如何有效降低 AIGC 疑似度?本文精选 5 个实用网站,从智能改写、精准优化等角度,为你提供解决方案。。
对预训练模型的所有参数进行再次训练,使其适应下游任务。
标注"×N"表示需要N张同型号显卡,建议使用NVLink桥接。:A800/H800相比原版带宽降低约30%,适合合规要求场景。
微调后的模型被保存在 /home/hy/source/code/transformer/LLaMA-Factory/saves/Qwen2.5-VL-7B-Instruct/lora/train_2025-07-27-12-30-16 中, ui会显示loss进度和进度条。下面是图片 2022-07-14--14-32-55--11_first/0553.png 的一些对话. 对话内容在QA_fr
evaluate库已经提供了大量评估函数的实现。这里使用了最简单的准确率acc和F1分值。• TP (True Positive):真*正例,即实际为正类,”正确“预测为正类的样本数。• TN (True Negative):真*负例,即实际为负类,”正确“预测为负类的样本数。• FP (False Positive):假*正例,即实际为负类,”错误“预测为正类的样本数。• FN (False N
然而,全面微调这类模型的成本仍然高昂,通常需要大量的计算资源、内存以及任务特定的数据。参数高效微调(PEFT)作为一种新兴的解决方案,通过仅更新模型的一小部分参数,使得大模型能够高效地适应下游任务。。我们首先分析了传统微调所面临的资源与可及性挑战,指出过拟合、灾难性遗忘和参数低效等关键问题。
大模型指令微调(Instruction Tuning)是一种针对大型预训练语言模型的微调技术,其核心目的是增强模型理解和执行特定指令的能力,使模型能够根据用户提供的自然语言指令准确、恰当地生成相应的输出或执行相关任务。指令微调特别关注于提升模型在遵循指令方面的一致性和准确性,从而拓宽模型在各种应用场景中的泛化能力和实用性。在实际应用中,我的理解是,指令微调更多把LLM看作一个更智能、更强大的传统N
视学算法专栏作者:腾讯游戏知几AI团队,西北工业大学音频、语音与语言处理研究组(ASLP@NPU)近日,腾讯游戏知几AI团队与西工大ASLP组联合发布了基于 WenetSpeech 1 万小时数据训练的中文版 Wav2vec 2.0 和 HuBERT 模型。Wav2vec 2.0 [1],HuBERT [2] 和 WavLM [3] 等语音预训练模型,通过在多达上万小时的...
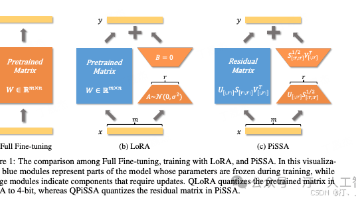
LoRA(Low-Rank Adaptation of Large Language Models,大型语言模型的低秩自适应)是一种流行的轻量级训练技术,可以显著减少可训练参数的数量。它的工作原理是将少量的新权重插入模型中,并且只训练这些权重。这使得使用 LoRA 进行训练的速度更快、内存效率更高,并且生成的模型权重更小(只有几百 MB),更易于存储和共享。LoRA 还可以与 DreamBooth
该方法主要通过增加恒定块扩展模型层数,使模型在增量训练过程中仅训练新增层、冻结原始层,保持模型原有能力,防止模型出现灾难性遗忘现象。但有两点存疑:目前来说mistral要好于llama,为啥不用mistral进行实验不用恒定块,性能会差多少。
自然语言到 SQL(NL2SQL)技术提供了一种以模型为核心的新型范式,它能将自然语言查询转换为 SQL 命令,从而为非技术用户简化数据库访问流程。近年来的技术进展,尤其是融合检索增强生成(RAG)与思维链(CoT)推理的技术,在提升 NL2SQL 性能方面取得了显著成效。然而,大型语言模型(LLMs)在任务分解不准确、关键词提取不精准等方面仍面临挑战,这些问题已成为导致 SQL 生成出错的主要瓶
参数高效微调PEFT(二)快速入门P-Tuning、P-Tuning V2
情感分析通常被视为一个分类问题:给定输入文本,输出情感类别(如0表示负面,1表示正面)。BERT模型通过预训练学习语言表示,微调时仅需添加一个分类层。交叉熵损失函数:用于优化分类任务。给定真实标签$y$和预测概率$\hat{y}$,损失定义为: $$L = -\sum_{i} y_i \log(\hat{y}_i)$$ 其中$i$表示类别索引,最小化$L$可提高模型准确性。BERT的嵌入层:输入文
情感分析属于文本分类任务,目标函数可表示为: $$P(y|x) = \text{softmax}(W \cdot \text{BERT}(x) + b)$$ 其中 $x$ 为输入文本,$y \in {\text{正面}, \text{中性}, \text{负面}}$。
CLIP视觉塔是EVA-02模型中的一个强大组件,它通过提供高层次的视觉特征表示,使得EVA-02能够在各种视觉任务中表现出色。其大规模参数和对自然语言的高度对齐能力,使得EVA-02在零样本和少样本任务中也具有显著的优势。
本项目基于EfficientNet模型实现了斯坦福狗数据集的图像分类任务。文章详细介绍了EfficientNet架构的优势(B0-B7不同变体),提供了完整的安装指南和数据预处理流程。采用两阶段训练策略:先冻结预训练层训练顶层,再解冻部分层进行微调。重点讲解了层冻结策略、超参数选择等关键技术细节,并提供了训练流程说明和可视化方法。该项目展示了如何利用EfficientNet的高效特性,在特定分类任
Below are some investigation resources for synthetic datasets:1. Synthetic datasets vs. real images for computer vision algorithm evaluation?https://www.researchgate.net/post/Synthetic_datasets_vs...
多分类的增量模型定义和二分类很类似,在全连接网络进行修改就行了。对多分类问题进行处理后,就能对增量微调形成一套自己的理解,这是最基础的知识,但也算是对Ai大模型的学习踏入门槛了。对于各位初学者而言,需要自行进行学习和训练,相信各位一定能很快轻松上手。
QLoRA与量化技术结合QLoRA将量化技术与LoRA相结合,通过4比特量化基础模型并使用LoRA进行微调,大幅减少显存需求,使得在消费级GPU上也能微调大型模型。这使得更多开发者和研究者能够参与到模型定制中来。
如果你是一个开发者,手里有一个强大的语言模型(LLM),想用它来做点厉害的事情,比如文本分类、智能问答,或者识别文本里的关键信息。可问题来了:训练这么一个庞然大物需要海量的计算资源和时间,你手头的电脑可能累到冒烟,甚至还有数据不够多导致模型“学歪”的风险。别慌,今天我们就来聊聊四种LLM微调方法,帮你高效优化模型,轻松应对各种场景。这四种方法分别是:Full-tuning(全量微调)、Freeze
在这项研究中,UIUC 和 Amazon 团队提供了实证和理论的双重证据,挑战了 “领域 SFT 会显著损害通用能力” 的普遍认知。在大模型微调实践中,SFT(监督微调)几乎成为主流流程的一部分,被广泛应用于各类下游任务和专用场景。比如,在医疗领域,研究人员往往会用领域专属数据对大模型进行微调,从而显著提升模型在该领域特定任务上的表现。然而,问题随之而来:SFT 是否会让模型 “遗忘” 原本的通用
在模型微调中,各类参数就像是你在给模型 “补课” 之前制定的教学计划和策略。它们决定了你如何教学、教学的强度以及教学的方向。如果你选择的教学计划不合适(比如补课时间太短、讲解速度太快或复习策略不合理),可能会导致学生学习效果不好。同样,如果你选择的超参数不合适,模型的性能也可能不理想。过去经常收到很多同学的问题:“在微调过程中这些参数到底要怎么设置效果才最好?
AVM 合成数据仿真验证技术为自动驾驶环境感知发展带来助力,可借助仿真软件配置传感器、搭建环境、处理图像,生成 AVM 合成数据,有效加速算法验证。然而,如何利用仿真软件优化传感器外参与多场景验证,显著提升AVM算法表现?
转载请注明出处,楼燚(yì)航的blog,http://www.cnblogs.com/louyihang-loves-baiyan/目前呢,caffe,theano,torch是当下比较流行的Deep Learning的深度学习框架,楼主最近也在做一些与此相关的事情。在这里,我主要介绍一下如何在Caffe上微调网络,适应我们自己特定的新任务。一般来说我们自己需要做的方向,比如在一些特定的领域的.
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模
很高兴能为您撰写这篇技术博客文章。让我们开始吧!"微调技术的创新应用"1. 背景介绍近年来,微调技术在机器学习领域引起了广泛关注。微调技术是指在预训练模型的基础上,通过少量的样本和有限的计算资源,对模型进行再训练和优化,以适应特定的任务或数据场景。与从头训练一个全
本文主要分享如何使用 LLaMAFactory 实现大模型微调,基于 Qwen1.5-1.8B-Chat 模型进行 LoRA 微调,修改模型自我认知。本文的一个目的:基于模型进行微调,修改模型自我认证。修改前对于模型,用户问你是谁?时模型一般会回答我们希望在微调之后,对于同样的问题,模型能回答。
使用LLaMA-Factory对LLM大模型进行微调!训练专属于你的模型!
本文详细介绍了大语言模型的几种关键技术:提示词工程、上下文学习(包括零样本、单样本和少样本学习)以及指令微调。文章解释了这些技术的基本概念、使用场景和局限性,特别指出上下文学习在小模型上效果不佳且受上下文窗口限制。针对这些局限,文章提出了指令微调作为解决方案,并讨论了多任务微调和参数高效微调(PEFT)等技术来避免灾难性遗忘问题。