登录社区云,与社区用户共同成长
邀请您加入社区
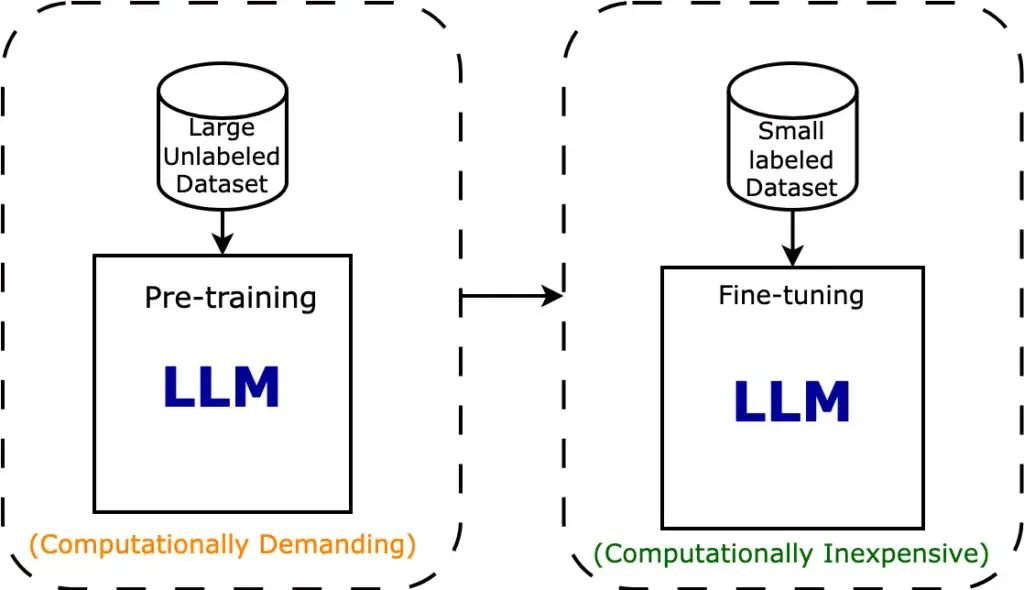
LLM(大语言模型)微调一直都是老大难问题,不仅因为微调需要大量的计算资源,而且微调的方法也很多,要去尝试每种方法的效果,需要安装大量的第三方库和依赖,甚至要接入一些框架,可能在还没开始微调就已经因为环境配置而放弃了。今天我们分享一个开源项目可以快速进行 LLM 微调,它不单运行效率高,而且还可以在微调过程中进行可视化,非常方便,它就是:LLaMA Factory。
本文将直接使用 Qwen2.5-VL-7B-Instruct 模型在 coco_2014_caption 数据集上进行LoRA微调训练,旨在熟悉Qwen2.5-VL数据处理和训练流程。GitHub地址:https://github.com/Donvink/Qwen2.5-VL-Finetune
CLIP视觉塔是EVA-02模型中的一个强大组件,它通过提供高层次的视觉特征表示,使得EVA-02能够在各种视觉任务中表现出色。其大规模参数和对自然语言的高度对齐能力,使得EVA-02在零样本和少样本任务中也具有显著的优势。
©作者 |机器之心编辑部来源|机器之心鉴于语言模型预训练成本巨大,因而研究者一直在寻找减少训练时间和成本的新方向。Adam 及其变体多年来一直被奉为最先进的优化器,但其会产生过多的开销。本文提出了一种简单的可扩展的二阶优化器 Sophia,在与 Adam 比较中,Sophia 在减少了 50% step 数量的情况下实现了与 Adam 相同的验证预训练损失。大语言模型(LLM)的能力随着其规...
每天给你送来NLP技术干货!行早 发自 凹非寺量子位 | 公众号 QbitAI华为诺亚方舟实验室开源了第一个亿级中文多模态数据集:悟空。这个新发布的数据集不仅规模大——包含1亿组图文对,而...
本文详细介绍了如何基于StabilityAI的Stable Diffusion XL(SDXL)模型进行全量微调训练。
数据集覆盖了 14 种不同类型的无人机,具体型号如下:shahed-131、shahed-136、orlan-10、Techyon、mavic 3、zala-42116E、Lancet、mojahed、superCam、zala-42104M、granat-4、granat-2、granat-1、forpost,涵盖了多种常见的军用与民用无人机类型,能满足不同场景下无人机检测算法的训练需求。在使用
本文旨在解决预训练点云模型全量微调(FFT)带来的高昂存储和计算成本问题。为此,论文提出了一种全新的参数高效微调(PEFT)方法,名为PointGST(点云图谱调优)。其核心技术贡献是设计了一个轻量级、可训练的点云谱域适配器(PCSA),在冻结预训练模型的同时,通过**图傅里叶变换(GFT)**将模型内部的点云令牌从空间域转换到谱域进行优化。这一转换利用正交的谱基向量有效解耦了空间域中易混淆的令牌
在SFT的基础上,通过强化学习和人类反馈来进一步微调模型,使其输出更加符合人类的偏好或期望。
微调是采用预训练模型并使用更多数据对其进行训练以创建更适合特定任务的新模型的过程。您可以在自己的图像上微调像SDXL这样的图像生成模型,以创建更擅长生成特定人物、对象或样式图像的新版本模型。对于大多数用户来说,BLIP为训练生成的描述效果很好。但是,您可以通过在提供的训练输入图像zip文件中添加caption.csv文件来提供自己的描述。每个输入图像都需要有相应的描述。有关格式的具体细节,请参阅示
24年11月来自北大、智源和香港中文大学的论文“Lift3D Foundation Policy: Lifting 2D Large-Scale Pretrained Models for Robust 3D Robotic Manipulation”。
LLaVA 是一种大型多模态模型,通过指令微调将视觉编码器与大型语言模型(LLM)相结合,显著提升了视觉和语言任务的性能,尤其在多模态对话和指令遵循方面表现出色。
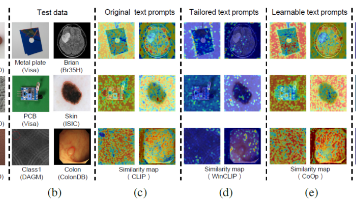
AnomalyCLIP 针对传统视觉语言模型在零样本异常检测(ZSAD)中的局限,通过三项关键创新突破挑战:采用对象无关的提示学习,以 “正常的对象”“损坏的对象” 等通用模板替代特定类别提示,摆脱对对象语义的依赖;引入对角突出注意力图(DPAM),通过值 - 值(V-V)注意力增强对细粒度异常的捕捉;利用全局 - 局部上下文优化,结合图像级分类损失与像素级分割损失,兼顾异常判断与定位。
这些大型图像生成模型(如 FLUX.1 和 Stable Diffusion)在一堆添加了噪声的图像上进行训练,并学习“添加噪声”的反向功能。令人惊讶的是,这竟然是“创建图像”。他们怎么知道要创建哪幅图像?他们以 CLIP 和 T5 等转换器模型为基础,这些模型本身经过大量图像-标题对的训练。这些是语言到图像的编码器:它们学习将图像及其标题映射到高维空间中的相同形状。当您向他们发送文本提示时,例如
跨模态转移旨在利用大型预训练模型来完成可能不属于预训练数据模态的任务。现有的研究在将经典微调扩展到跨模态场景方面取得了一定的成功,但仍然缺乏对模态差距对转移的影响的理解。在这项工作中,进行了一系列关于转移过程中源表示质量的实验,揭示了更大的模态差距与较少知识重用之间的联系,这意味着转移效果不佳。然后,使用条件分布 P(Y|X)P(Y|X)P(Y|X) 将这种差距形式化为不同模态之间的知识不对齐..
使用预训练的 3D ResNet 实现简单的视频动作识别
上下游任务是先后关系,上游任务先让模型学习到通用特征..
目录问题与方案一、Introduction二、Related Work三、Method3.1、Dual-encoder for Video-text Pre-training: a revisit3.2、Multiple Choice Questions 3.3、Pre-training Objectives3.4、Model Architecture3.4.1、VideoFormer3.4.2、
有时,我们需要利用预训练网络权重提取全连接前的特征。需要将全连接去除掉,然后后面根据自己的任务进行修改。self.feature_extraction = models.resnet34(pretrained=True)self.feature_extraction.fc = nn.Sequential()# remove fc或者,在设计网络层面,将对应的fc去除掉,然后按对应键对进行加载即可。
最近对大模型这部分内容比较感兴趣,作者最早接触大模型是22年下半年的时候。当时觉得非常amazing,并认为这是一个颠覆性的工作,目前随着开源大模型的逐渐变多。我觉得我们得学习并了解这些基础知识,以便后续在工作中可以学习并使用。在深度学习中,微调是一种重要的技术,用于改进预训练模型的性能。除了微调ChatGPT之外,还有许多其他预训练模型可以进行微调。以下是一些微调预训练模型的方法::将预训练模型