登录社区云,与社区用户共同成长
邀请您加入社区
精确的医学图像分割需要整合从局部特征到全局依赖的多尺度信息。然而,现有方法在建模长距离全局信息方面存在挑战,其中卷积神经网络受到其局部感受野的限制,视觉变换器因其注意力机制的高二次复杂性而受到限制。最近,基于Mamba的模型因其在长序列建模方面的卓越能力而受到广泛关注。一些研究表明,这些模型可以在各种任务中胜过流行的视觉模型,提供更高的准确性、更低的内存消耗和更小的计算负担。然而,现有的基于Mam
包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!😝有需要的小伙伴,可以保存图片到。
前端源码:链接:https://pan.baidu.com/s/1SVB1c1nl9NnfTf2uT0OyUg。6.通过postgres-Pgvector充当向量数据库,实现RAG技术对⼤模型进⾏微调,实现定制化输出;前端:cursor对话式开发,Vue3 + Element Plus + Vite。3.重写redis存储对话上下⽂,原存储使⽤的jvm;7.⽀持pdf、⽂本⽂件、MarkDown⽂
是在大规模数据上进行无监督或自监督学习训练得到的模型。例如在自然语言处理中,像 BERT(Bidirectional Encoder Representations from Transformers)、GPT(Generative Pretrained Transformer)系列等都是典型的预训练模型。这些模型通过学习大量文本数据中的语言模式、语义信息和语法结构等知识,形成了对语言的深度理解能
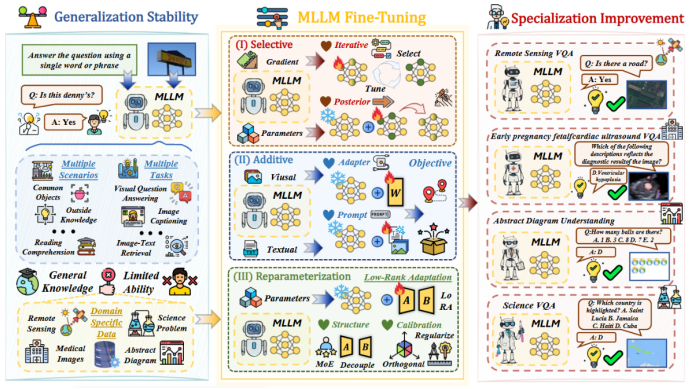
模态大语言模型(MLLMs)展现出卓越的通用能力,在视觉与语言推理任务中表现出色,并具备一定的跨任务泛化能力。但是,其在某些下游领域的应用能力有限。通过在下游数据上进行微调,MLLM能够灵活适配多种任务,从视觉问答到医学诊断等领域,展现出惊人的潜力。这是否意味着MLLM的下游微调已发展到足以应对不同领域的复杂挑战,并有效解决模型迁移与泛化问题的程度?不同类型的微调方法在应对这些挑战时各有哪些优势和
©作者 | 董冠霆单位 | 北京邮电大学研究方向 | 自然语言理解论文标题:FactPEGASUS: Factuality-Aware Pre-training and Fine-tuning for Abstractive Summarization收录会议:NAACL2022论文链接:https://arxiv.org/abs/2205.07830代码链接:https...
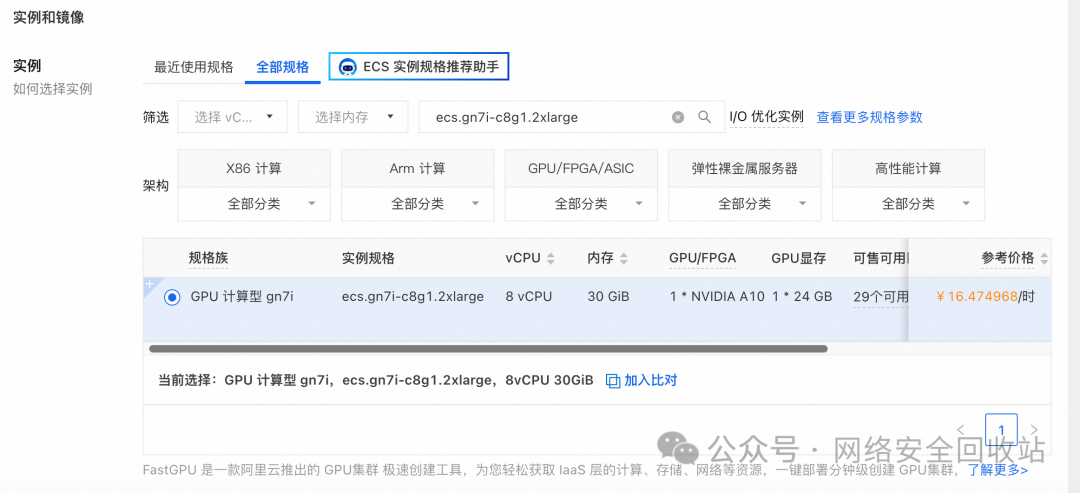
在安装深度学习及大模型微调环境时,经历了多次反复操作(如CUDA、cuDNN、PyTorch的安装与卸载)。为了避免走弯路,总结了以下步骤,供大家参考。
本文主要总结本人最近跑过的大模型微调项目。相信大家这几个月都会不断新出的微调大模型项目刷屏,频率基本每天都有高星的项目诞生,部分还宣称自己达到GPT的百分之多少,一方面弄得大家过度乐观,一方面弄得大家焦虑浮躁。面对这种情况,我的建议是「多动手」。把这些项目 clone 下来,跑跑代码,把项目用到的数据集下载下来做做EDA,把项目训练完的checkpoint下载下来,用自己的例子跑跑。多接触反而心态
众所周知,大语言模型(LLM)正在飞速发展,各行业都有了自己的大模型。其中,大模型微调技术在此过程中起到了非常关键的作用,它提升了模型的生成效率和适应性,使其能够在多样化的应用场景中发挥更大的价值。那么,今天这篇文章就带大家深入了解大模型微调,主要包括什么是大模型微调、什么时候需要大模型微调、大模型微调方法总结、大模型微调最佳实践等。
1,由于作者是首次使用jdk17,相关涉及的方面有点多,很多jar包版本对应问题,以及spring doc的接入问题,都存在着很多坑就不在赘叙,引用pom的包就可以避免所谓的jar包冲突问题。2,知识文档向量化存储到redis,redis需要安装redissearch,实现向量化检索。1,知识库向量化模型gte-large-zh。1,逻辑推理AI大模型 Qwen3-14B。4,知识库查询结果嵌入提
本文将从**什么是模型?什么是模型训练?什么是模型微调?**三个问题,来展开介绍人工智能基础的模型部分。模型族谱模型是一个函数:将现实问题转化为数学问题(Encoder编码器),通过求解数学问题来得到现实世界的解决方案(Decoder解码器)。,这个模型是一个函数,它根据输入数据(可以是文本、图像、语音、视频等)和一组参数(通常表示为权重)来预测输出。这里的输入和权重都是以数学形式(如矩阵或张量)
在人工智能迅猛发展的今天,大型预训练语言模型(如GPT、BERT等)已成为自然语言处理领域的核心技术。然而,这些"通用"模型在面对特定业务需求时往往表现不尽如人意。本文将深入探讨大模型微调(Fine-tuning)的技术原理,详细分析其工作机制,并重点阐述在实际业务场景中何时需要微调而非直接使用基础模型。大模型微调(Fine-tuning)是指在预训练好的大型语言模型基础上,使用特定领域或任务的数
Android 官方网站是:https://www.android.com/其下的开发者网站是:https://developer.android.com/其下的源代码文档网站是:https://source.android.com/我相信作为正当上网的网民应该是打不开上面的网址的,后来在中国开通了google.cn,可...
LLaMA Factory 是一个开源的微调框架,旨在帮助开发者高效地微调和部署大型语言模型(LLM),如 LLaMA、BLOOM、Mistral 等。它通过提供用户友好的 LlamaBoard Web 界面,降低了使用门槛,使得即使没有深厚编程背景的用户也能轻松进行模型微调和推理操作。LLaMA Factory 支持多种微调方法,包括全参微调、冻结微调和轻量化的 LoRA 微调,能够显著降低显存
我想咨询个问题,是不是我这种工作一年,备考一年,相当于有两年gap的学生,在筛选阶段就会被一票否决啊。本人24届应届,秋招和春招拿了车企和大厂的offer,分别是自动驾驶和大模型,但最近越来越想去国企,楼主目前在一个小厂的开发岗实习,之前投的字节测开岗约了hr面,现在有点纠结小厂氛围不错,就是不知道能。目前小论文投稿出去了,想出去实习,但是导师一开学就说不让实习,该怎么办呢,是偷着出去还是跟老师商
当大语言模型(LLMs)进入消费市场时,人人都想分一杯羹。然而随着时间的推移,我们开始渴望超越单纯的语言建模能力。视觉是首个被攻克的模态领域之一,这使得大量视觉语言模型(Vision Language Models,VLMs)涌向市场。